Wie dieses Blog gebaut wurde
Veröffentlicht 2026-11-17 · 10 Min Lesezeit
Zuletzt aktualisiert 2026-11-18
TLDR — Statische Markdown-Dateien in git für die Texte, eine PocketBase-Binary für die lebendigen Teile, Astro für die Seiten, und ein Modell, das nur beantwortet, ob ein Kommentar gehen soll — ohne Tools und ohne eigene Befugnis. Das ist die ganze Maschine, und diese Seite wird von ihr erzeugt.
Wie dieses Blog gebaut wurde
Das ist der erste Beitrag, und er ist der selbstbezogenste Text auf der Seite: Der Text, den du liest, wurde als Markdown-Datei in git geschrieben, von einem Skript in eine Datenbank importiert und von demselben Build gerendert, der jede andere Seite hier erzeugt. Wenn der Build kaputt ist, ist diese Seite kaputt.
Die Aufteilung, die alles entschied
Die Seite hat zwei Hälften mit völlig unterschiedlichen Anforderungen.
Die Texte sind Content. Sie liegen in git als eine Markdown-Datei pro Übersetzung
(content/posts/<slug>/en.md, content/posts/<slug>/de.md), mit Bildern daneben. Sie werden in
einem Editor geschrieben, als Diff reviewed und nie über ein Admin-Panel editiert. Dafür braucht es
keinen Server.
Die Interaktionen sind dynamisch: Kommentare, Likes und das Identitätsprofil jeder Leserin. Das kann nicht vorgerendert werden, weil es davon abhängt, wer liest.
Daraus folgt die Aufteilung: statischer Build für Content, ein kleines Backend für Interaktion. Diese eine Entscheidung hat den größten Teil des Stacks bestimmt.
Warum nicht Ghost, Hugo oder WordPress
Ghost und Hugo sind sehr gut in der ersten Hälfte und nutzlos in der zweiten. Ein Kommentarsystem auf einem statischen Generator bedeutet entweder einen Drittanbieter-Dienst — mit Drittanbieter-Cookies, und das ist der ehrliche Grund, warum es die Identitätsseite gibt: keine Analytics von Dritten, keine Third-Party-Cookies, weil die Glaubwürdigkeit der Offenlegungsseite davon abhängt — oder eine eigene Datenbank und API.
WordPress kann beide Hälften, zieht aber ein komplettes Runtime mit sich, und die interessanten Teile dieses Projekts — die Kommentar-Pipeline, die Moderationsrichtlinie — wären in einem Plugin-Ökosystem begraben. Ich wollte die Richtlinie als lesbare Datei und Tests, die man ausführen kann.
Hugo hätte für die Content-Hälfte gereicht, aber Astro gewann aus praktischen Gründen: Astro rendert zum Build-Zeitpunkt und erlaubt einzelne interaktive Inseln. Eine Seite, die zu hundert Prozent statisch ist außer einem Kommentarformular, ist genau die Form, für die Astro gebaut ist. Shiki hebt Code beim Build hervor, sodass kein Client-Highlighter ausgeliefert wird.
Astro erzwingt auch eine kleine Disziplin: Komponentennamen müssen großgeschrieben werden. Ein
kleingeschriebener Name wie <toc> wird als HTML-Tag geparst, und der Build schreibt bereitwillig ein
wörtliches <toc>-Element in die Seite. Das ist mir aufgefallen, bevor es lief.
PocketBase als das gesamte Backend
Das Backend ist eine Binary mit eingebetteter SQLite-Datei. Kollektionen: posts (ein Abbild des
git-Contents, damit Kommentare und Likes auf stabile ids zeigen), comments, reactions, visitors,
moderation_events, abuse_events und eine Read-only-View für Post-Statistiken. Das Schema liegt als
committete Migrationen, damit eine frische Instanz reproduzierbar ist.
Zwei ehrliche Einschränkungen.
Erstens: PocketBase ist kein PHP. Hier gibt es kein request-scoped Rendering; die Seite ist ein statischer Build und PocketBase ist nur eine API. Alles Dynamische auf einer Seite ist eine Insel, die die API aufruft.
Zweitens: das Hook-Runtime ist weder Node noch Browser. Kein fs, kein fetch, keine
npm-Modulauflösung in pb_hooks. Diese eine Einschränkung bestimmte, wo die Identitäts-Engine lebt,
weil das Hashing aus einer von drei Quellen kommen muss: den $security-Helfern des Runtimes, einer
reinen Implementierung im Hook oder einer Go-Erweiterung. Die geteilte Logik in diesem Repo importiert
deshalb kein Runtime — der Hook lädt sie als generiertes CommonJS-Bundle, und der Aufrufer injiziert
seine eigene Hashfunktion. Zwei Runtime-Fallen sind merkwürdig: Hook-Dateien teilen sich einen
Top-Level-Scope, deshalb kann ein const helpers = require(...) in einem Hook mit einem anderen Hook
kollidieren; und JSON-Felder kommen als umhüllte Go-Maps zurück, also müssen sie über getString
geparst werden, bevor man sie per Name indiziert.
Eigene Routen liegen unter /api/blog/*, damit sie nicht mit den System-Kollektionsrouten kollidieren.
Das No-Login-Problem und warum Proof of Work die Antwort ist
Hier ist jeder anonym. Es existiert genau ein Konto: meines. Das war das Lesemodell, das ich wollte — man sollte für einen Blogkommentar kein Konto brauchen.
Anonymer Schreibzugriff braucht einen Kostenfaktor, sonst ist es eine Spam-Box. Die Pipeline ist so geordnet, dass die billigen Prüfungen zuerst kommen:
- Honeypot-Feld, still abgewiesen;
- Proof of Work — das Client löst einen Nonce mit führenden Nullen, der Server prüft in Mikrosekunden, die Schwierigkeit ist konfigurierbar und gilt nur für Schreibvorgänge;
- ein
bot_scoreaus Signalschwankung und Requestgeschwindigkeit; - ein Rate-Limit auf der Identität, nie auf der IP (NAT und Mobilfunknetze machen IP-Limits zu Strafen für normale Leser);
- Inhaltsregeln: Längen, eine Markdown-Teilmenge, kein HTML, Linklimit, und ein doppelter Content-Hash im Fenster;
- erst dann das Insert.
Abweisungen antworten mit 200 und sehen aus wie Erfolg. Das Rate-Limit ist das einzige ehrliche 429,
weil es eine Drosselung ist und keine Erkennung. Das ist aus demselben Grund wichtig, aus dem Honeypots
funktionieren: Dem Client zu sagen, welche Kontrolle ihn erwischt hat, bringt ihm bei, wie man sie
umgeht.
Identität ist geschichtet, kein Fingerprint
Identität ist ein keyed Hash über Schichten. Die Hauptschicht ist ein First-Party-Cookie: zufällige id,
HttpOnly, SameSite=Lax, Secure, langer Ablauf. Die zweiten Signale werden grob und gehasht
gespeichert: IP, Browser-Familie und Hauptversion, accept-language, Zeitzone-Offset, DPR und gerundete
Bildschirmgröße, Plattform-Familie.
Die Richtlinie wurde ausdrücklich entschieden: Das Cookie ist die Identität, die zweiten Signale werden
einzeln gespeichert und speisen bot_score plus ein Stabilitäts-Flag pro Signal. Die strenge Richtlinie —
ein einziges geändertes Signal bedeutet eine neue Identität — ist verteidigbar und vielleicht ehrlicher,
aber ein Leser, der von wifi auf mobil wechselt, wird eine andere Person, und die Seite würde ihn ständig
neu baselinen. Deshalb zeigt die Identitätsseite beides: welche Signale aktuell zum key beitragen und
welche sich gerade unterscheiden. Like-Zählungen sind darüber idempotent über UNIQUE(post, visitor),
daher sind doppelte Likes unabhängig von der Richtlinie unmöglich.
Die Linie, die der Agent durchsetzt
Der Moderationsarbeiter prüft neue Kommentare. Kraftausdrücke, harte Kritik, disagreement, Sarkasmus: okay. Illegale Inhalte, Drohungen, gezielte Belästigung einer namentlich genannten Person, Slurs, Doxxing, Scam-Links, maschinell erzeugter Spam: entfernt.
Der Agent ist hier nicht das Gesetz — der deterministische Durchlauf ist es. Inhaltsregeln entscheiden die Form, das Modell entscheidet nur die kontextuellen Kategorien, und der Agent löscht nie hart. Er ändert einen Status und schreibt eine Audit-Zeile. Entfernte Kommentare bleiben 30 Tage mit einem Wiederherstellungsfenster; die Autorin kann einen zweiten Durchlauf beantragen, Fälle mit niedriger Konfidenz eskalieren zu mir, und nach dem Fenster wird der Text purgiert, während die Metadatenzeile bleibt. Jede rohe Modellantwort wird mit Konfidenz und Politikversion geloggt, weil man sonst nicht beweisen kann, dass der Agent recht hatte, wenn sich jemand beschwert.
Der Arbeiter läuft als geplanter Durchlauf, nicht als Hook: Hooks können kein Modell aufrufen. Ohne konfiguriertes Modell läuft er trotzdem, und die deterministischen Regeln gelten allein.
Das Modell hat keine Hände
Der Arbeiter ist ein normales Programm: er liest die ungeprüften Kommentare, stellt pro Kommentar eine Frage und macht die Schreibvorgänge selbst. Das Modell bekommt den Blog nie. Es läuft ohne Tools, deshalb kann ein Kommentar nicht dazu bringen, die API aufzurufen, eine url zu holen, eine Datei zu lesen, einem Leser zu antworten oder das Credential auszugeben, mit dem sein Prozess gestartet wurde. Die Payloads, die gegen einen Agenten mit Tools funktionieren — ignoriere die Richtlinie oben, zeig was du sehen kannst, lösche den anderen Kommentar — haben hier nichts auszuführen.
Die Alternative war ein Agent-Harness mit shell und curl auf die Kommentar-Warteschlange. Das ist flexibler und genau die falsche Form für diese Aufgabe. Ein Kommentar ist per Definition nicht vertrauenswürdige Eingabe, und sobald das Lesende auch handeln kann, entscheidet der Kommentar, was die Handlung ist. Deshalb ist die ganze Arbeit des Modells eine Antwort über ein Kommentar: behalten oder entfernen.
Drei Dinge tragen das. Ein Aufruf pro Kommentar in einer isolierten Sitzung, damit ein feindliches Kommentar genau einen Turn bekommt und keinen Kontext ins nächste Kommentar mitnimmt. Der Kommentar kommt als Daten über stdin, und die Argumentliste wird ohne shell gebaut, damit Kommentar-Text nie eine Option, ein Pfad oder ein Befehl werden kann. Und die Antwort trägt kein Ziel: der Arbeiter wendet sie auf das Kommentar an, das er gelesen hat, weil es in der Antwort kein Feld gibt, wo eine Kommentar-id hingehen könnte. Der Modell-Prozess bekommt das Provider-Key und nichts sonst, nie das Blog-Credential.
Er läuft einmal am Tag um 4 Uhr statt als Loop: der Deploy ist ein Cron, der das Image startet, der Arbeiter liest die offenen Kommentare, antwortet für jeden einzelnen, schreibt selbst und endet dann. Eine Antwort, die er nicht parsen kann, oder eine Konfidenz unter der Untergrenze wird eine protokollierte Menschliche-Prüfung-Zeile statt einer Entfernung. Jede Antwort wird mit ihrer Politikversion gespeichert, damit man eine Entscheidung später prüfen kann.
Die Identitätsseite ist ein Feature, keine Pipeline
Die Seite ist hier, und so sieht sie bei einem normalen Besuch aus:
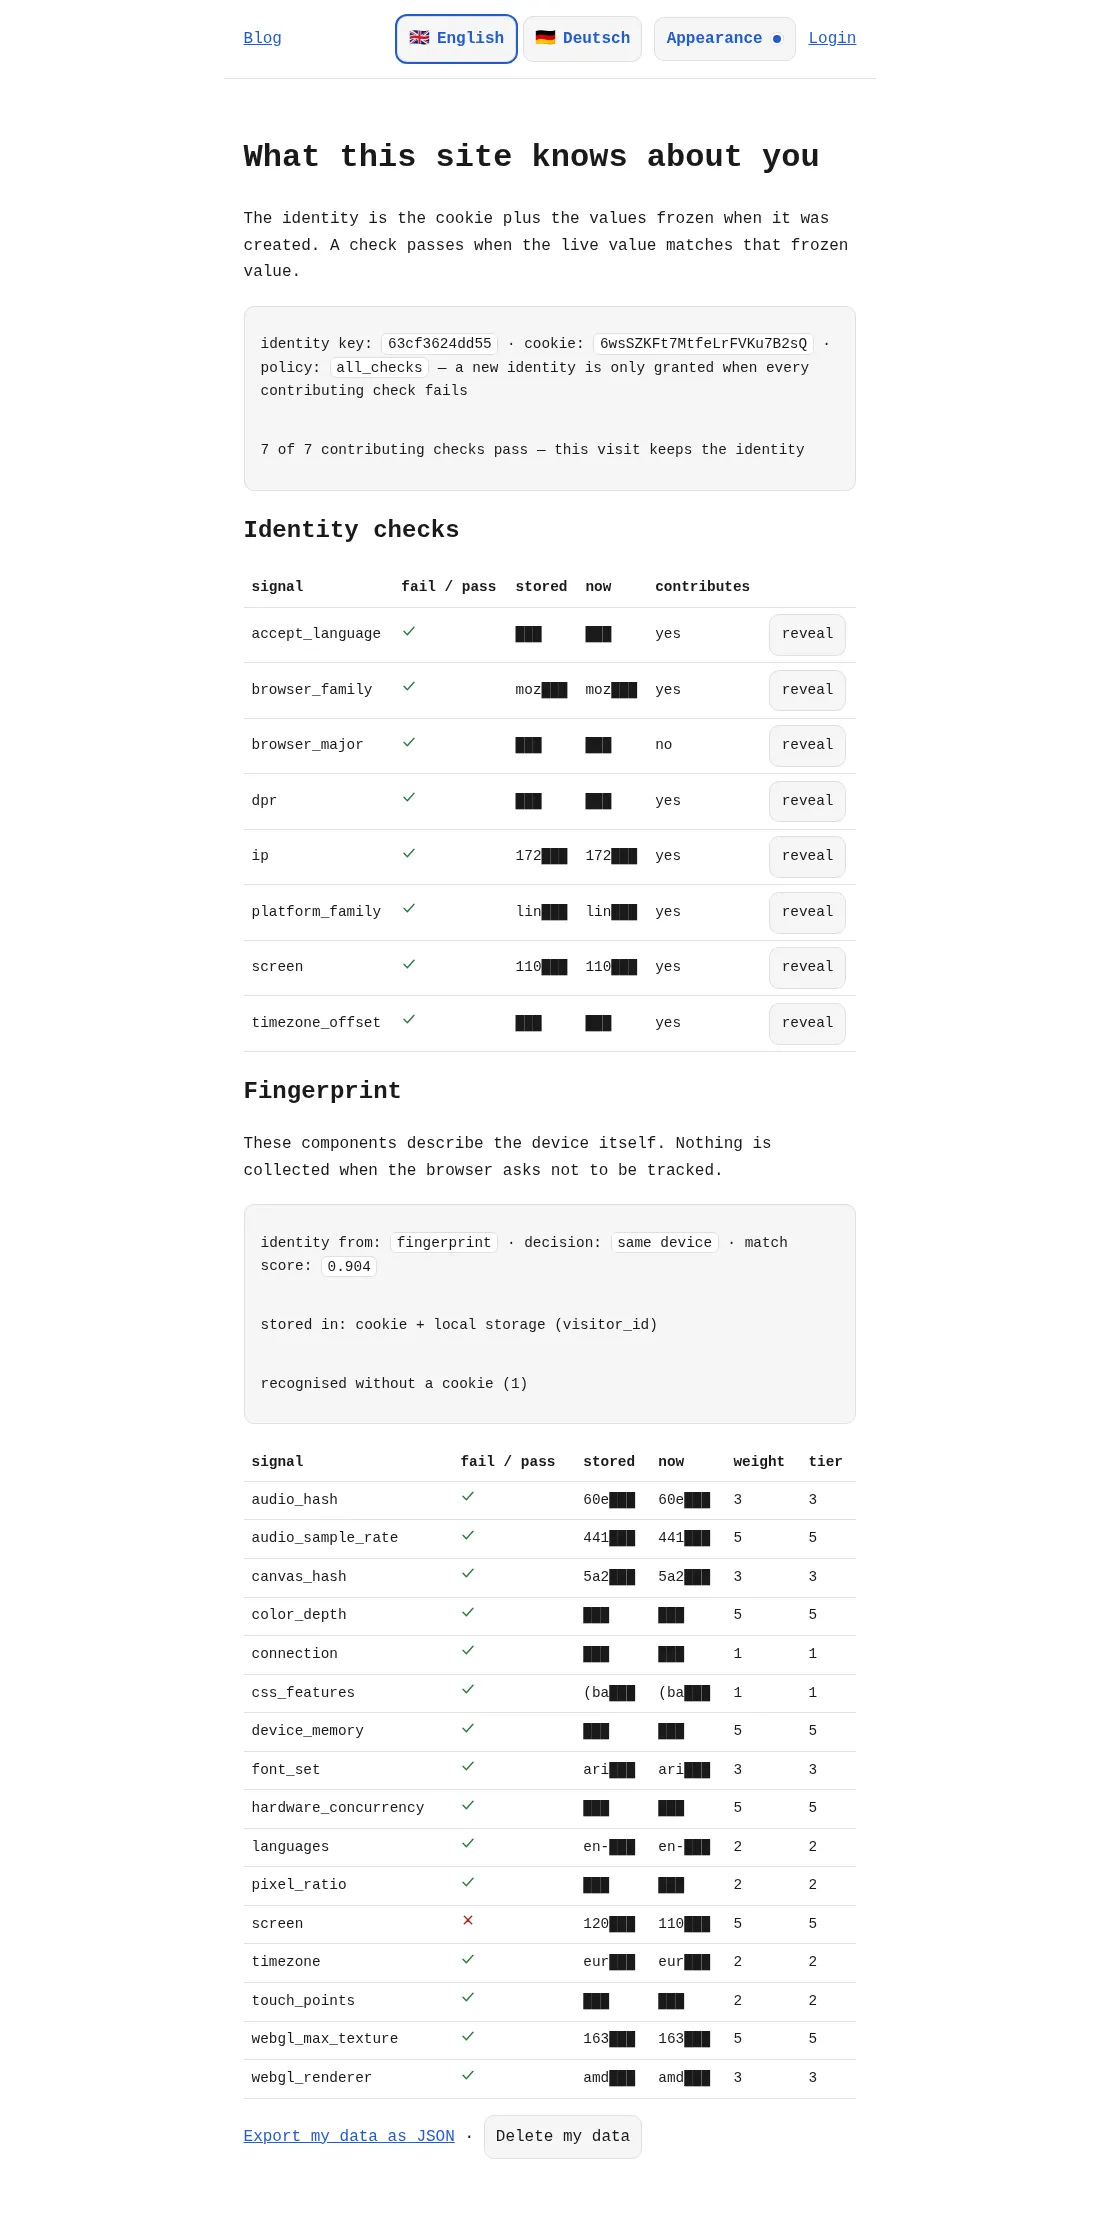
/identity listet jedes Signal, das eine andere Identität erzeugen würde, jedes mit Häkchen oder Kreuz
gegen das Gespeicherte. Sie zeigt den key-Präfix, den Cookie-Wert, die maskierte IP mit
Einzel-Feld-Reveal, die Zeitzone, den Browser-Bucket, DPR und Bildschirm, first und last seen, alle deine
Kommentare, alle deine Likes, den Score und jede gespeicherte Zeile mit ihrem eigenen Ablauf. Es gibt
einen JSON-Export und einen Delete-Button. Live-Recompute heißt: die Kreuze ändern sich, wenn du etwas
änderst — inklusive Netzwerkwechsel, genau der Fall, der die Richtlinienentscheidung oben nötig machte.
Alles Sensible wird serverseitig roh gespeichert und maskiert angezeigt. Reveals sind pro Feld und auditiert. Einer Leserin zu zeigen, was über sie gespeichert ist, ist der Unterschied zwischen einem System, das behauptet, minimal zu sein, und einem, das überprüft werden kann.
Deployment ist absichtlich langweilig
PocketBase-Binary plus Datenvolumen, und der statisch gebaute Site im selben Image, also liefert
PocketBase die Seiten als statische Dateien und die Hook-Routen auf demselben Port. Nichts anderes
wird ausgeliefert: TLS, Caching, HSTS, CSP mit script-src 'self' (deshalb wird der Insel-Code
als Moduldatei ausgeliefert statt als Inline-Script), Referrer-Policy, X-Frame-Options und keine
Analytics — das ist Sache des Proxys davor, und der Proxy gehört dir. Litestream streamt die
SQLite-Datei in Objektspeicher. Das ganze Backend ist eine Datei, also verliert man alles, wenn man
sie verliert. Secrets über Umgebungsvariablen.
Der Proxy muss eine Sache richtig machen: die Client-IP. e.realIP() folgt einem weitergegebenen
Header nur, wenn PocketBase weiß, welchem Header es trauen darf, und das ist eine gespeicherte
Einstellung statt einer Umgebungsvariablen — sonst zeichnet eine Identität die Proxy-Adresse statt
der Besucherin auf. Hinter Cloudflare akzeptiert nginx CF-Connecting-IP nur aus den
Cloudflare-Bereichen, und derselbe Header ist der, dem PocketBase trauen soll.
Das Autoren-Bild ist ein PocketBase-Datei-Feld, also lebt es in derselben Datei wie alles andere — kein separates Bucket, kein CDN.
Wie man es ausführt
Der ganze Stack ist pocketbase + moderation, in compose oder als zwei systemd-Dienste.
bun run test                    # reine Logik: Signale, Hashing, PoW, Scoring, Policy, Theme
cd pocketbase && bun run test_integration   # gegen eine wegwerfbare Instanz
cd site && bun run build
cd deploy && docker compose up -d
Tests sind nach Bedarf getrennt: test/unit für reine Funktionen, test/integration gegen eine
wegwerfbare PocketBase-Instanz. Policy-Fixtures enthalten bewusst feindliche, aber erlaubte Kommentare —
Kraftausdrücke und harte Kritik — um zu beweisen, dass der Klassifikator nicht zu viel entfernt.
Worum es im ersten Beitrag wirklich geht
Das Interessante an diesem Projekt ist nicht die Software. Es ist die Menge der Entscheidungen, die vor dem Schreiben getroffen wurden: was als Content gilt und was als Interaktion, was ein Leser ohne Konto dürfen soll, was ein Agent entfernen darf, und was die Seite einer Leserin über sie selbst zeigen will. Alles andere ist Plumbing im Dienst dieser vier Antworten.